ClojureでJavaのクラスを生成するのは、とても簡単でした
前回はJavaのライブラリーを呼び出す話だけしかしていなくて、ごめんなさい、これは明らかな片手落ちでした。オブジェクト指向プログラミングの良いところはフレームワークに代表される制御構造の逆転*1で、だから、クラスの継承やインターフェースの実装を使用した、ライブラリーから呼び出される場合についても述べなければ不十分でした。
というわけで、今回は、Javaのクラスの継承やインターフェースの実装に関する話をさせてください。
ライブラリー間の依存にやられました
前回で述べたのWebDAVツールは、最初はJackrabbit WebDAVを使って作り始めました。Jackrabbit WebDAVはとても便利で、たとえば、以下のような短いコードでWebDAVのPROPFINDメソッドを使ってHREFを取得するコードを実装できます。
;; project.clj
(defproject spike-clojure "1.0.0-SNAPSHOT"
  :description "FIXME: write description"
  :dependencies [[org.clojure/clojure                     "1.4.0"]
                 [org.apache.jackrabbit/jackrabbit-webdav "2.5.0"]
                 [org.slf4j/slf4j-api                     "1.6.6"]
                 [org.slf4j/slf4j-simple                  "1.6.6"]])
(ns spike-clojure.core
  (:import [org.apache.commons.httpclient HttpClient UsernamePasswordCredentials])
  (:import [org.apache.commons.httpclient.auth AuthScope])
  (:import [org.apache.jackrabbit.webdav DavConstants])
  (:import [org.apache.jackrabbit.webdav.client.methods PropFindMethod]))

(defn hrefs
  []
  (let [c (doto (HttpClient.)
            (-> (.getState)
                (.setCredentials AuthScope/ANY
                                 (UsernamePasswordCredentials. "username" "password"))))
        m (PropFindMethod. "http://webdav.server/webdav/directory/"
                           DavConstants/PROPFIND_ALL_PROP DavConstants/DEPTH_1)]
    (.executeMethod c m)
    (->> (-> (.getResponseBodyAsMultiStatus m)
             (.getResponses))
         (map #(.getHref %)))))
と・こ・ろ・が、途中でこのJackrabbit WebDAVが使えないことが判明しちゃったんですよ。
Jackrabbit WebDAVはHttpClientの3.0に依存していて、HttpClientの3.xはNTLM認証(Windows NT Lan Manager authentication)のversion 2を使った認証には対応していなくて*2、で、このツールを実行する環境のプロクシーはNTLMv2で認証をかけていたいたんですよ……。
で、HttpClientの4.xならばNTLMv2にも対応しているのですけれど、3.xと4.xではAPIが大きく異なるので、Jackrabbit WebDAVではHttpClientの4.xは使えませんでした……。というわけで、Jackrabbit WebDAVを使って楽ちんプログラミングという夢は潰えてしまいました。
もー、ライブラリー間の依存とか非互換は勘弁してくれー!
※信じられないかもしれませんが、ごめんなさい、ここまで前振りです。
HttpClient 4.xで、PROPFINDを実装してみる
というわけで、HttpClient 4.xにWebDAVの機能を追加することにしました。やりたくはないけど、ないんだからしょうがありません。
HttpClientの文書を見てみると、新しいHTTPのメソッドを追加するときには、HttpRequestBaseもしくはそのサブ・クラスを継承すればよいみたい。参考にするために、JavaのHttpPostMethodのコードを見てみます。コメントを削除して抜き出してみると、以下のような感じ。
public class HttpPost extends HttpEntityEnclosingRequestBase {
  public final static String METHOD_NAME = "POST";

  public HttpPost() {
    super();
  }

  public HttpPost(final URI uri) {
    super();
    setURI(uri);
  }

  public HttpPost(final String uri) {
    super();
    setURI(URI.create(uri));
  }

  @Override
  public String getMethod() {
    return METHOD_NAME;
  }
ふーん、いろいろやっているけど、つまりはHttpRequestBaseのサブ・クラスのHttpEntityEnclosingRequestBaseを継承して、で、getMethod()をオーバーライドするだけで良いのね。HttpEntityEnclosingRequestBaseを継承している理由は、POSTする内容をHttpEntityEnclosingRequestBase.setEntity()でセットするため。
ということは、匿名クラスを作成してそのインスタンスを返してくれるClojureのproxyマクロを使って、以下のように書けばOKってわけですな。
(proxy [HttpEntityEnclosingRequestBase] []
  (getMethod [] "PROPFIND"))
proxyマクロの第一引数は、継承元のクラスや実装元のインターフェースのベクターです。第二引数は、継承元のクラスのコンストラクタに渡す引数。あとは、オーバーライドする関数です。上の場合だと、getMethod()メソッドをオーバーライドするというわけですな。
あれ、でも、HttpPostのコンストラクタでやっている、setURIしている部分はどうしましょう?proxyのリファレンスを調べても、コンストラクタに関する記述は見つかりません。proxyだとコンストラクタは書けないの?初期化できないじゃん!というか、そもそも属性はどうするのよ?
なんて心配は、ご無用です。初期化する関数を用意すれば、コンストラクタがなくても大丈夫。実際に書いてみましょう。
(defn http-propfind
  [uri]
  (doto (proxy [HttpEntityEnclosingRequestBase] []
          (getMethod [] "PROPFIND"))
    (.setURI uri)))
え?なんだかピンと来ない?かなり偏った例ですから、それはそうですよね……。もう少しわかりやすい、属性に相当するものの管理がある例も挙げましょう。
以下のJavaのインターフェースがあるとします。
public interface Named {
  public String getName();
  public void setName(String name);
}
これをClojureで実装してみたのが、以下のコードになります。
(defn named
  [name]
  (let [n (atom name)]
    (proxy [Named] []
      (getName [] @n)
      (setName [name] (reset! n name)))))
ほら、初期化は関数内で実施して、で、属性の管理はクロージャを使えば良いわけ(Clojureでは変数は不変なので、変更可能なatomを使っています)。ね、コンストラクタとか属性とかがなくても、別に困らないでしょ?
と、疑問が解消したところで、WebDAVのPROPFINDの仕様を見てみます。ふむふむ、1)リクエストはXMLで送る、2)DepthはHTTPヘッダーで設定する、3)結果はXMLで返ってくるのね。
はい、すべて了解です。WebDAVのPROPFINDの仕様も加味した最終的なコードは、以下のようになりました。
(ns spike-clojure.core
  (:require [clojure.xml])
  (:import  [java.net URI])
  (:import  [org.apache.http.auth AuthScope UsernamePasswordCredentials])
  (:import  [org.apache.http.client.methods HttpEntityEnclosingRequestBase])
  (:import  [org.apache.http.entity StringEntity])
  (:import  [org.apache.http.impl.client DefaultHttpClient]))

(defn http-propfind
  [uri]
  (doto (proxy [HttpEntityEnclosingRequestBase] []
          (getMethod [] "PROPFIND"))
    (.setURI    uri)
    (.addHeader "DEPTH" "1")
    (.setEntity (StringEntity. (str "<?xml version=\"1.0\"?>"
                                    "<D:propfind xmlns:D=\"DAV:\">"
                                    "  <D:allprop />"
                                    "</D:propfind>")))))

(defn hrefs
  []
  (let [c (doto (DefaultHttpClient.)
            (-> (.getCredentialsProvider)
                (.setCredentials AuthScope/ANY
                                 (UsernamePasswordCredentials. "uasername" "password"))))
        m (http-propfind (URI. "http://webdav.server/webdav/directory/"))]
    (->> (-> (.execute c m)
             (.getEntity)
             (.getContent))
         (xml/parse)
         (xml-seq)
         (filter #(= (:tag %) :D:href))
         (map #(first (:content %))))))
XMLのパースの分だけ少し行が増えていますけど、それ以外の部分、Javaのクラスを継承したりインターフェースを実装したりする部分は、ほら、簡単でしょ?
ClojureでJavaのクラスを生成するのは、とても簡単でした
proxyマクロと、Clojureが提供する高階関数やクロージャーを使えば、簡単にJavaのクラスを継承したりインターフェースを実装したりできます。そして、クラスの継承とインターフェースの実装ができるならば、フレームワークのような制御の逆転を伴うライブラリーを使うことができます。つまり、豊富なJavaのライブラリーを使って、Clojureで何でもできちゃうというわけ。
高階関数とクロージャーを使ったステート管理は、Javaな人には気持ち悪いかもしれませんけど、JavaScriptだったり.NET FrameworkだったりClojureだったりする人にとってはごく自然なやり方でしょう。つまり、Javaのクラスを継承したりインターフェースを実装したりする場合でも、Clojure流の気持ち良いプログラミングができちゃうというわけ。
うん、やっぱりClojureは素晴らしい!
JavaのAPIを使う場合でも、やっぱりClojureらしくプログラミングしたい
この前、Clojureでwebdavからバイナリー・ファイルをダウンロードするツールを作ったんですよ。
私はClojureでファイル入出力をするプログラムを作るのは初めてでしたから、いつものようにCheat Sheetでやり方を調べようとして、で、愕然としました。
「バイナリーのファイル入出力の関数が異常に少ない!*1」
ま、ほら、たぶん、アレですよ。Clojureは表現力が豊かな言語なので、こんな少ない関数でも十分なバイナリー・ファイルの入出力ができる……わけなんかあるかぁ!全部Java任せじゃないかぁ!
裸のClojureでバイナリー・ファイルを読み込んでみる
簡単な仕様で試してみましょう。ファイルを読み込み、他のファイルに書き出すという仕様*2のコードを書いてみます。
といっても、Clojureにはclojure.java.ioパッケージにcopyという関数がすでにありますから、そのソース・コードの劣化版(オリジナルにはあったバッファリング処理を省略しました)の引き写しですけど。
(ns spike-clojure.core
  (:require [clojure.java.io :as io]))

(with-open [i (io/input-stream  "/tmp/i.bin")
            o (io/output-stream "/tmp/o.bin")]
  (loop []
    (let [b (.read i)]
      (when (>= b 0)
        (.write o b)
        (recur)))))
io/input-streamやio/output-streamは、JavaのInputStreamやOutputStreamのインスタンスを生成します。だから、InputStreamのメソッドであるreadやOutputStreamのメソッドであるwriteを呼び出せるというわけ(Clojureでは、メソッド名の前に「.」をつけるとJavaのメソッドの呼び出しになります)。ほら、Clojureにおけるバイナリー・ファイルの処理は、Java任せでしょ?
で、その、うーん、なんだか格好悪いですな……。
シーケンス!シーケンス!シーケンス!
どこがどう格好悪いのかというと、使い慣れたfilterやmapが使えない点が格好悪いです。上のコードでは、0は無視するとか、1を2に変更するとかするには、コードそのものを変更しなければなりません。
でも、だからといって、事前にファイルを全部読んでbyteのベクターに入れて、ベクターなのだからfilterでもmapでも自由に使えるからオーケー……ってのは、強引過ぎるでしょう。ファイルがメモリに乗らないくらい大きい可能性がありますからね。
というわけで、Clojureらしくシーケンスを使いましょう。シーケンスを作るのに必要な作業はlazy-seqマクロを間に挟むだけ、とっても簡単です(しかも、今回はClojureのline-seq関数をお手本にできます)。さっそくコードを書いてみましょう。
(ns spike-clojure.core
  (:require [clojure.java.io :as io])
  (:import  [java.io InputStream]))

(defn byte-seq
  [^InputStream input-stream]
  (let [b (.read input-stream)]
    (if (> b 0)
      (cons b (lazy-seq (byte-seq input-stream))))))

(with-open [i (io/input-stream  "/tmp/i.bin")
            o (io/output-stream "/tmp/o.bin")]
  (dorun (->> (byte-seq i)
              (map #(.write o %)))))
byte-seqが、シーケンスを作る関数です。この関数は引数としてInputStreamが渡されることを前提にしていますので、引数の前に^InputStreamと書いて型を指定します。その上で、EOFで処理を止められるように、ifで.readした結果が0以上かを確認します。で、あとは、consする際にlazy-seqを挟んでおくだけ。
ほら、これで、シーケンスが使えるようになりました。with-open以下で、作成したbyte-seqを使ってコピーをしています。今回は.writeという副作用を伴う処理を実施したいので、dorunで囲みました。シーケンスなので、出力部分に使い慣れたmapを使用することができています。もちろん、出力するmapの前にfilterを入れることだって可能です。
このコードなら、ほら、書いていて気持ち良いですよね?
Javaの手続き的な処理を、関数でラップしてシーケンスにしちゃいましょう
lazy-seqを使えば、手続き的な処理をシーケンスを使う形にラップできます。JavaのAPIのようなガチガチの場合であっても、関数でラップしてlazy-seqを挟んであげれば、ほら、シーケンスを使ったClojureらしいプログラミングができるというわけ。
また、そもそも、ClojureにはJavaのコレクションをシーケンスとして扱えたり、Javaの正規表現クラスや、テキストを扱うReaderをシーケンスとして扱うための関数があったりします。
で、いったい何を言いたいのかというと、ClojureからJavaを使う場合でも、ほんの少し工夫すれば気持ちよくプログラミングできますよって話をしたいんです。
昔どこかで読んだ評価にClojureは小さすぎるって書いてあって、いやいやClojureはJavaのライブラリを使えるから十分に大きいんだと反論したくて、でもJavaのライブラリを使ってもClojureのあの気持ち良いプログラミングができるのかは分からなかったので、だから、そのときは黙っていました。
でも、今回、ClojureからJavaのライブラリを使うプログラミングをやってみて、ほんの少しの工夫で十分に気持ち良くプログラミングできることが分かりました。だからそう、PCの前で独り言でClojureは十分に大きんだと主張して、で、ついでにこのブログに書いたという次第でございます。
というわけで、Javaのライブラリを使えば何でもできて、しかもプログラミングしていて気持ちが良いClojureは素晴らしい!
DSLを難しく考えるのは、もうやめにしませんか?
前回は偉そうにDSL(Domain Specific Language)について語ってしまった私ですけど、じゃあお前が作ったDSLを見せてみろと言われたら、とても困っちゃう。
困ってしまう理由は、DSLを作っていないからではありません。「DSLと呼ぶにはあまりにもちょぼくさいと感じられるものしか作っていない」からなんです。
でも、その、私は、「DSLは凄いもの」という考え方の方が間違えているんだと考えています。DSLなんてのはごく当たり前の技術で、だから、ちょぼくさいDSLがあっても当たり前なのだと考えています。
……ごく当たり前の技術を使って凄いモノを作ることができることを鑑みれば、ちょぼくさいDSL「しか無い」部分については、世間様のDSLに対する理解ではなく、私のスキルの方に問題がある気もしますけど。
言語=文法+語彙
さて、言語というのは、文法と語彙の2つで出来ていると考えます。プログラミング言語の場合、語彙ってのはライブラリになるでしょう。
我らがClojureの場合、文法は以下だけ。もー、とにかく小さい。
1) シンボルに関するルール(数字以外で始まって、英数字もしくは記号が続く)
2) データ表現に関するルール(リテラルとかリストとかキーワードとか)
3) リーダー・マクロ('(Quote)とか。9個)
4) スペシャル・フォーム(defとかifとか。15個)
5) 評価ルール(リストの最初の要素を、残りを引数にして評価する)
で、残りの言語要素は、Clojureの場合は全て語彙です。数値演算、例えば+なんてのも語彙です。だって、クロージャーのコードを見ると、+を定義する関数がありますからね*1。
さらに、Clojureでは、特定の名前空間内で、語彙の実装を変更することができます。論より証拠。+と-を入れ替えてみましょう。REPLを起動して、以下を入力してみてください。
user=> (defn + [a b] (clojure.core/- a b))
WARNING: + already refers to: #'clojure.core/+ in namespace: user, being replaced by: #'user/+
#'user/+
user=> (defn - [a b] (clojure.core/+ a b))
WARNING: - already refers to: #'clojure.core/- in namespace: user, being replaced by: #'user/-
#'user/-
これでuser名前空間では+が引き算に、-が足し算になりました。さっそく、試してみましょう。
user=> (+ 1 2)
-1
user=> (- 1 2)
3
はい、高校時代に数学のテストが毎回赤点だった私による「ぼくがかんがえたさいきょうのすうがく」の完成です。
語彙を入れ替えていくだけでも、新しい言語になります
関数やマクロを定義していけば、文法として挙げた部分はClojureなのだけど、それ以外は異なるモノを作ることができます。そして、Clojureでは文法の占める割合はとても小さい。だから、その結果として出来上がったモノは、元となったClojureとは多くの部分が異なっています。
もちろん、文法はそのままなのですから、見た目をJavaのコードのようにすることはできません。カッコは多いままですし、「foo(1, 2)」ではなくて「(foo 1 2)」と書かなければなりませんし、「1 + 2」ではなくて「(+ 1 2)」のような書き方になるでしょう。
でも、私は、それは新しい言語なのだと考えます。
考えてみましょう。もし、Clojureにmap関数が無かったらどうなるでしょうか?再帰なりloop/recurなりを使う面倒なコードを書かなければなりません。たぶん、こんな感じ*2。
(defn map-x2
  [xs]
  (if-let [x (first xs)]
    (cons (* x 2)
          (map-x2 (rest xs)))))

(map-x2 [1 2 3])
対して、mapがある場合のコードは、こんな感じ*3。
(defn x2
  [x]
  (* x 2))

(map x2 [1 2 3])
mapがあると、コードがとても簡潔になると思いませんか?集合に対して関数を適用するmapという単語が追加されたことの効果は、目を見張るものがあると思いませんか?そう、まるで別の言語みたいに。
思わない?なら、現実のレベルの喩え話で。「萌え」という言葉が発明されてから、秋葉原ドメインにおける表現は非常に簡潔になったと思いませんか?2ちゃんねるの各種用語なんかもそう。この前読んだ、「まおゆう」という小説の主人公が「魔王」と「勇者」(名前が無い)で、前置きなしで物語が魔王と勇者の対決場面から始まっていても物語を理解できたのは、同じ話なのだと考えます。
内部DSLを難しく考えるのは、もうやめにしませんか?
というわけで、萌えでもツンデレでもリア充は氏ねでも、なんでも構いません。貴方のアプリケーション専用の語彙を作ることにしましょう。
たとえば、リレーショナル・データベースを使うアプリケーションであれば、データの取得や更新をするための関数とマクロとデータ構造を作ってしまいましょう*4。たとえば、勤怠管理のアプリケーションで勤怠の入力チェックが複雑なのであれば、ルール・エンジンを作ってしまいましょう。
Clojure(というかLisp全般)は強力な言語なので、かなり面白いことができると思います。例えば、上に挙げた勤怠の入力チェックのルール・エンジンを、Prolog風の言語として作っちゃうとか*5。
でも、別に、無理に面白くする必要はないとも、思うんですよ。
つまるところ、内部DSLは一種のAPI(Application Programming Interface)です。で、私は、内部DSLと普通のAPIとの違いは、夾雑物が少ない(対象ドメイン以外のことを書かなくて済む)か否かでしかないと考えています。
たとえば、Javaの世界で「流れるようなインターフェース」が内部DSLとして扱われているのは、普通のAPIを使う場合には必要な、型を含む変数の宣言やメッセージを送付する先のオブジェクト、代入、他のAPIの呼び出し等を書かなくてよいからなのだと考えます。
ただね、ここで困っちゃうんですけど、言語のコアが小さいClojureの場合、もともと夾雑物が少ないんですよね。だから、対象ドメインで必要となる関数を一通り揃えただけでも、Clojureの場合は内部DSLになっちゃう。なので、中には、ちょぼくさいんだけどこれは内部DSLなんだと主張できるようなモノも存在しちゃえるというわけ。
というわけで、最初に述べた話に戻ります。DSLを難しく考えるのは、もうやめにしませんか?
もっと気楽に構えて、気軽に書いて、で、もっと積極的に内部DSLを活用してみませんか?「Clojureとアプリケーション」の二層構造から「Clojureと内部DSLとアプリケーション」という三層構造にすることで楽になる部分は、けっこう多いと思いますよ。うん、(ちょぼくさいものであっても)内部DSLは素晴らしいですな。
*1:その内部では、実はJavaのレベルの実装を呼び出しているんですけど。
*2:ごめんなさい。話を簡単にするために、遅延シーケンス周りは無視しました。
*3:本当は(def x2 (partial * 2)にしたかったのですけど、比較しづらくなるので、普通の掛け算で書きました。
*4:参考になるかは分からないけど、たとえばこんなの(load-datasetの所を見てみてください)。手前味噌ですみません。
*5:「例えば」です。今の私に作れるわけではありません。著名ハッカーのPaul Grahamさんが「On Lisp」の中でCommon Lispでやっていたから、Clojureでもできると思いますが……。今度、チャレンジしてみます
XMLを使うフレームワークの嫌なところ
この前、久しぶりにJavaのフレームワークを使う仕事をやりました。やはり、多くのビジネス・アプリケーション開発で採用されているJavaのフレームワークは素晴らし……くないぞぉ!なんだか使いづらいじゃないかぁ!
つらつらとその理由を考えてみたところ、「XMLが悪い」という結論になりました。今回は、その話を。
それにしても、Javaのフレームワークは使いづらいなんて書いちゃって大丈夫なのかなぁ、私ってば。……大丈夫、読んでいる人なんかほとんどいないから。
Apache Tilesを使って、ドハマリしました
今回作ったアプリケーションのページ構成は、以下のような感じでした。
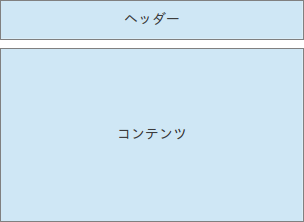
ページ間で内容が同じヘッダー等の要素を複数回書くと保守性が下がってしまいますから、フレームワークの中にパーツをページに組み立てる何らかの仕組みがあるはず*1。今回フレームワークとして使用したのはSpringでしたので、Springのリファレンスを読んでみます。
はい、ありました。17.3 Tilesの記述によれば、Apache Tilesを使えばよいみたい。小さなプログラムを作って試してみます。以下のような感じ。
layout.xmlの抜粋

<definition name="/content" template="/WEB-INF/jsp/view.jsp">
  <put-attribute name="title"   value="コンテンツ" />
  <put-attribute name="content" value="/WEB-INF/jsp/content.jsp" />
</definition>
view.jsp

<%@ page contentType="text/html; charset=utf-8" %>
<%@ page pageEncoding="utf-8" %>

<%@ taglib uri="http://tiles.apache.org/tags-tiles" prefix="tiles" %>

<!DOCTYPE html>
<html lang="ja">
  <head>
    <title>Springを試してみました - <tiles:getAsString name="title" /></title>
    <link rel="stylesheet" href="/resources/css/spike-spring.css" />
  </head>
  <body>
    <div id="header" class="layout">
      <p>ここがヘッダー。</p>
    </div>
    <div id="content" class="layout">
      <tiles:insertAttribute name="content" />
    </div>
  </body>
</html>
content.jsp

<%@ page pageEncoding="utf-8" %>

<p>ここがコンテンツ。</p>
ふむふむ、XMLファイルでページの要素を定義して、その要素を実際に配置する部分はJSPでやるのね。配置の具体的なやり方は、Apache Tilesのタグ・ライブラリを使えばよい、と。うん、実に分かりやすい。
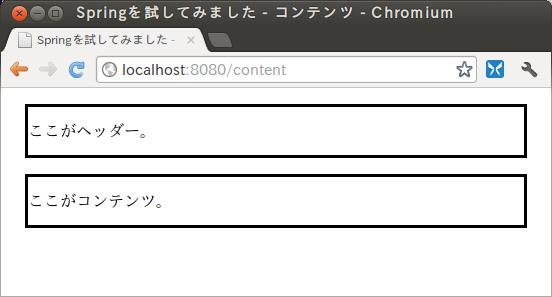
はい、動きました(ごめんなさい、テスト用なのでかなり画面がダサいです)。
プログラミングを進めましょう。今回作成したアプリケーションには、以下のようなcontentの部分がcontent-menuとcontent-bodyに分かれる画面もありました。
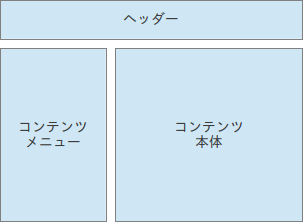
この要件に対応するには、2分割される場合用のdivided-content.jspを書いて、2分割する場合用のXMLを定義すればよいでしょう。以下のような感じです。
divided-content.jsp

<%@ page pageEncoding="utf-8" %>

<%@ taglib uri="http://tiles.apache.org/tags-tiles" prefix="tiles" %>

<div id="content-menu" class="layout left-float">
  <tiles:insertAttribute name="content-menu" />
</div>

<div id="content-body" class="layout right-float">
  <tiles:insertAttribute name="content-body" />
</div>

<div class="reset-float">
</div>
layout.xmlの抜粋

<definition name="/divided-content" template="/WEB-INF/jsp/view.jsp">
  <put-attribute name="title" value="分割されたコンテンツ" />
  <put-attribute name="content" value="/WEB-INF/jsp/divided-content.jsp" />
  <put-attribute name="content-menu" value="/WEB-INF/jsp/content-menu.jsp" />
  <put-attribute name="content-body" value="/WEB-INF/jsp/content-body.jsp" />
</definition>
content-menu.jsp

<%@ page pageEncoding="utf-8" %>

<p>ここがコンテンツのメニュー。</p>
content-body.jsp

<%@ page pageEncoding="utf-8" %>

<p>ここがコンテンツの本体。</p>
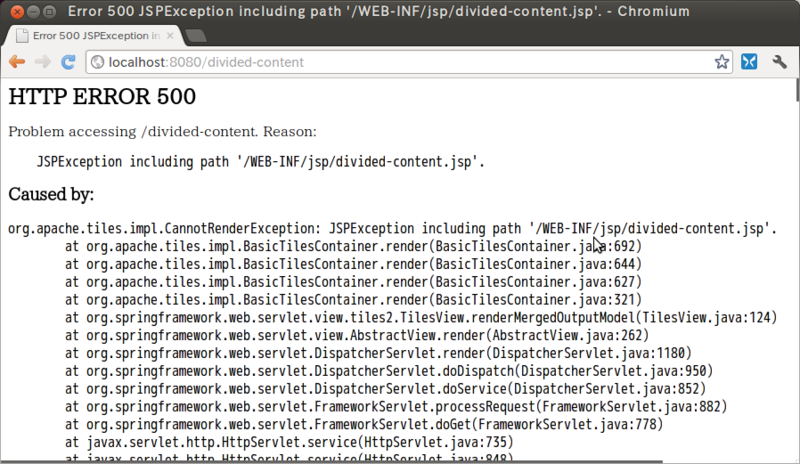
はい、動かして……みたら、あれ?エラーになっちゃって動かない!
もー大慌てでApache Tilesの文書を読んで、締め切り間際にNesting Definitionsの記述に辿り着きました。
というわけで、XMLを以下のように修正します。
layout.xmlの抜粋

<definition name="/divided-content" template="/WEB-INF/jsp/view.jsp">
  <put-attribute name="title" value="分割されたコンテンツ" />
  <put-attribute name="content">
    <definition template="/WEB-INF/jsp/divided-content.jsp">
      <put-attribute name="content-menu" value="/WEB-INF/jsp/content-menu.jsp" />
      <put-attribute name="content-body" value="/WEB-INF/jsp/content-body.jsp" />
    </definition>
  </put-attribute>
</definition>
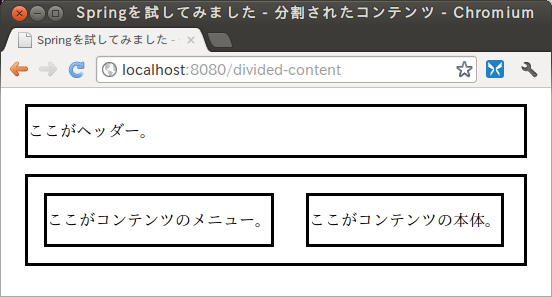
やったぁ、動きました。最終的に動いたからまぁよいんだけど、でも、Javaのフレームワークって、なんだか使うのが大変だなぁ……。
XMLは「外部」DSLです
え?お前に知識が無いのが悪いって?はい、おっしゃる通りです。すみませんした。え?お前はJavaやらないでClojureやっとけって?Clojureの仕事がねーんだよ!
さて、話は少し変わりますが、DSL(Domain Specific Language)という言葉があります。ある領域(Domain)に特化(Specific)した言語(Language)ですな。UNIX文化では様々なミニ言語が使われいて、これらがDSLの例になります(たとえば、正規表現とか)。あと、XMLを使用した設定ファイルも、DSLの1つ(設定という領域に特化した言語)なのだと考えます。
このDSLには、外部DSLと内部DSLがあります(あのマーチン・ファウラー先生による命名みたいです)。専用のコード・ジェネレーターとかインタープリターとかライブラリで解釈されるのが外部DSL、汎用言語の上に構築されたDSLが内部DSLになります。
で、XMLを使用した設定ファイルってのは、外部DSLなのだと思います。そして私は、外部DSLは使いづらいと考えているんです。
話を戻しましょう。Apache Tilesでは、<definition>は置き換えの指示、<put-attribute>は置き換えそのものという役割分担がされているのだと思います。<put-attribute>は置き換えそのものなので、JSPの中にさらに置き換えをする<tiles:insertAttribute>タグがあるとエラーになっちゃうのも、まぁ当然の話ですね。
……でも、あれ、ちょっと待ってください。<definition>と<put-attribute>の2つがあるわけですけど、本当に両方とも必要なのでしょうか?
Clojureでは「内部」DSLを使います
あーだーこーだ不満を言っているだけでは始まらないので、Clojureとcompojureとhiccupを使って、同じプログラムを書いてみます。以下がその結果(書いたコートのすべて)です。
(defproject spike-hiccup "1.0.0-SNAPSHOT"
  :description      "Spiking hiccup"
  :dependencies     [[org.clojure/clojure "1.4.0"]
                     [compojure           "1.1.1"]
                     [hiccup              "1.0.0"]]
  :dev-dependencies [[lein-ring           "0.7.1"]]
  :web-content      "public"
  :ring             {:handler spike-hiccup.core/app})
(ns spike-hiccup.core
  (:use [compojure core route handler])
  (:use [hiccup core page]))

(defn view
  [title content]
  (html5
   {:lang "ja"}
   [:head
    [:title (str "hiccupで試してみました - " (h title))]
    (include-css "/css/spike-hiccup.css")]
   [:body
    [:div.layout
     [:p "ここがヘッダー。"]]
    [:div.layout
     content]]))

(defn content
  []
  [:p "ここがコンテンツ。"])

(defn divided-content
  [content-menu content-body]
  (list
   [:div.layout.left-float
    content-menu]
   [:div.layout.left-float
    content-body]
   [:div.reset-float]))

(defn content-menu
  []
  [:p "ここがコンテンツのメニュー。"])

(defn content-body
  []
  [:p "ここがコンテンツの本体。"])

(defroutes main-routes
  (GET "/content"         [] (view "コンテンツ"
                                   (content)))
  (GET "/divided-content" [] (view "分割されたコンテンツ"
                                   (divided-content (content-menu)
                                                    (content-body))))
  (files "/"))

(def app
  (-> main-routes site))
コードの簡単な解説をさせてください。hiccupは、HTMLを生成するためのライブラリです。このhiccupを使うと、[:div ...]とかでHTMLを生成できます。上のコードのview関数がview.jspに相当するわけですな。で、defroutesマクロは、compojureが提供するHTTPリクエストと処理の対応付け機能です。"/content"というGETリクエストが来たら、(view ...)以下を評価した(「呼び出した」の意味です)結果を返す。このmain-routesが、layout.xml部分の役割も担っています。中を見ると、ほら、layout.xmlと似た内容が書かれているでしょ?
で、ここで注目していただきたいのですけど、Clojureのコードでは、「(レイアウト関数 レイアウト・パラメーター1 レイアウト・パラメーター2)」という表記で統一されています。レイアウト結果をパラメーターにしたい場合は、レイアウト・パラメーターを「(レイアウト関数 レイアウト・パラメーター1...)」に置き換えてるだけ。むちゃくちゃシンプルな構造になっています。
view等のHTML生成関数も見てください。<tiles:insertAttribute>に相当する部分も、ただ変数名を書いているだけです。変数名で表現できない場合(ロジックを介する必要がある場合)は、普通に関数を評価するコードを書くだけ。「[:title (str "hiccup..." (h title))]」とかね(strは文字列を生成する関数で、hはエスケープする関数)。やっぱり、めちゃくちゃシンプルです。
そもそもClojureでは、変数の値は「変数名」だけ、関数の評価をしたい場合は「(関数名 パラメーター ...)」と書くルールです。で、関数の評価をした結果をパラメーターにしたい場合は、パラメーターを「(関数名 パラメーター ...)」に置き換えるだけ。つまり、上で挙げたすべての話は、Clojureの文法を知っていれば調べるまでもない話なんですよ。Clojureも置き換えの指示も置き換えそのものも同じ文法でできちゃっているわけで、やたらめったらシンプルです。そう、前節の最後の疑問に対するClojureからの回答は、「<definition>と<put-attribute>の両方とも不要」なのです。
で、このhiccupは、内部DSLです。Clojureの中で実行できているわけですから「内部」。divided-content関数の中のdiv.layout.left-floatが<div class="layout left-float">に置き換えられているのはまさに文法の拡張で、HTML生成用の新しい言語なのだから「DSL」なのです。
私は、このようなシンプルで理解が簡単な構造を作れた理由は「hiccupが内部DSLだから」なのだと考えています。
私は、内部DSLが大好きです
内部DSLと外部DSLを比較してみましょう。
内部DSLの良い点として、拡張性が高いことが挙げられます。元の言語の機能を使い放題なわけですからね。対する外部DSLは、外部DSLを作成した時に考えた以上のことはできないという危険性があります。
反対に外部DSLの良い点としては、メインのコードから独立していることが挙げられるでしょう。XMLにJavaのコードは書けないわけですからね。対する内部DSLでは、HTMLを作っているんだかビジネス・ロジックを実行しているんだか分からないようなコードが書かれちゃう危険性があるわけです。
で、双方のメリットを勘案してどちらを取るのかと聞かれれば、私なら迷いなく内部DSLを選択します。複数の役割を持ったごちゃごちゃなコードを書いてしまうというのはDSLを使っていない場所でも発生しうる問題で、そのような品質が低いコードは問答無用で却下されるべきです。関数やメソッドは1つの機能のみを持つべきだというのは当たり前の話で、この程度のことに外部DSLを持ち出すまでもないと考えるためです。
いやいや、外部DSLのメリットはプログラムを書けない人でも保守が可能であることだ、という反論があるかもしれません。でも、layout.xmlの編集とmain-routesの編集なら、難易度は変わりませんよね?だから、どちらもプログラムを書けない人でも可能だと考えます。
コストの話をされる方がいるかもしれません。layout.xmlならビルドの手間が不要だからコストが小さいとの主張です。でも、Leiningenを使っているならばClojureのビルドはコマンド一発で完了するので、XMLにコスト面でのメリットはないと考えます。
テストのためにコードは入れ替えられないけれど外部DSLであるXMLならば入れ替えることができるとの主張も聞きます。でも、これはClojureでアスペクト指向の回に書いたようなテクニックを活用して動的にコードを置き換えれば、コードでも簡単にできる話です。なのでやっぱり、外部DSLを使う積極的な理由にはなりません。
結局のところ、外部DSLを使う本質的な理由は、「内部DSLを作れるほどに柔軟な言語を使っていない」なのだと考えます。これはあまりにも悲しい。ぜひ、Clojureで内部DSLを活用してみてください。Clojureはマイナーなので嫌だと言う場合は、メジャーな言語であるRubyを使用してみてください。Rubyでも内部DSLは活用されまくりですよ。
いやぁ、Clojure(やRuby)は素晴らしい!
*1:ごめんなさい。<jsp:include>の存在はすっかり忘れていました。
ベトナムにおける、優秀なプログラマーの見つけ方
いやぁ、ベトナム在住という特徴を活用するのを忘れていました……。私には、それくらいしか特別なところはないのにね。
というわけで、今回は、素敵なベトナム・ライフ……なんか知りません。私はプログラマーでヒキコモリなので、外を出歩きませんから。というか、そもそもベトナムのハノイに素敵な場所なんかないですし。
ですから、やっぱりコンピューターの話を。将来ベトナムで働くかもしれないプログラマーの皆様向けに、2012年7月現在での、仲間となる優秀なプログラマーを採用する方法について考えてみます。
高給待遇で、大量の応募者を集めましょう
まずは、高給の待遇を用意して、とにかく大量の応募者を集めるべきだと考えます。以下に、この結論に至った経緯を述べます。
ベトナムの学校での教育内容は、暗記が中心です。実は、ベトナムは科挙を世界で一番最後まで実施していた国です。科挙には「家柄ではなく学識に基づく官僚制度を創り上げたというメリット」だけではなく、「非実用的な知識の詰め込みだったというデメリット」があったわけで、残念なことに、ベトナムにはこのデメリットが色濃く残っているようです。昔、ベトナム人に試験問題を作らせたら、テキストの文中の重要ではない単語(inとか)を穴埋めさせる問題を作りやがりました。そんな問題、ページ丸ごと暗記していないと解けないっつーの。
また、教育の内容も古いようです。以前、大学に企業説明会で伺ったら、黒板に、プリエンプティブ・マルチ・タスクのOSがどーのこーのと書いてありました。この内容は、そろそろ就職しようという学生に教える内容じゃないよなぁ……。また、授業で使うプログラミング言語も、古き良きC言語が多いようでした。古くても内容が高度ならばそれでよい*1のですけれど、応募者にC言語のポインターについて聞くと、まともに答えられない場合が多かったです。
というわけで、情報工学系の大学を出ていても、そのプログラミング・スキルには期待できません。でも、
そんなことは問題にはならない!ウォーター・フォールならば、スキルの問題は発生しない。ウォーター・フォールでプログラマーに要求されるのは、設計書をコードに変換する作業なのだから!
と考えて、スキルの問題を無視している方が多いように思えます。
とーんでもなーい。
ビジネス・アプリケーションでウォーター・フォールを「完全に」運用するなんて絶対に無理!非現実的に過ぎます。ウォーター・フォールってのは工程単位で間違いがない完全な成果物を作り上げる(間違いが発見されたら後戻りしてやり直す)というやり方で、それには金と時間が必須なのです。金も時間も足りない普通のビジネス・アプリケーション開発における設計書には、間違いがいっぱいあります。SI(System Integration)プロジェクトのコストと期間の削減圧力なめんなって感じです。
だから、ウォーター・フォールを採用しているプロジェクトでは、多かれ少なかれ、問題にならない程度にズルをしていると思います。詳細設計とプログラミングを同じ技術者が担当して、ちょこちょことプログラミングしてから詳細設計書を書いたり。基本設計書の間違いを、基本設計書を修正せずに詳細設計書でだけ修正したり。よくあるのが、詳細を書かずに行間を読みながら後工程の作業をするというルールで運用しちゃうとか。ウォーター・フォールの下っ端のプロジェクトへの貢献を舐めんなって感じです。
ただ、このようなズルをまがりなりにも実施できているのは、いつでも前工程の担当者にヒアリングできる(ので曖昧なところや間違いがあってもすぐに解決できる)からなんですよね……。ベトナムでオフショアの場合は、残念なことに、いつでもヒアリングできるという前提が当てはまりません。
だから、日本側が頑張って完璧なウォーター・フォールを実施する……なんてのはオフショアを使うコスト削減の圧力が高いプロジェクトでは期待できないので、ベトナム側でどうにかしなければなりません。ヒアリングせずに、ヒアリングした場合と同じ結果を出すわけですな。設計書の矛盾を付きあわせ、システムの全体像を思い浮かべて正解を導き、ソース・コードの詳細を想像して最適な実装を提案し続ける。これを、直接コミュニケーションなしでやるわけ。うぅ、とてもキツイです。
だからそう、優秀ではないプログラマーには、完璧ではないウォーター・フォール、かつ、オフショア開発での下っ端はこなせません。優れたプログラミング能力と、仕様の全体像を理解できる頭の良さと、設計書の矛盾に気がつく細かさが必要になるのですから。で、ベトナムの教育内容では、こんな高度な作業ができる人は作られません……。
もちろん、ウォーター・フォールをやめるという選択肢もあります(プログラマーの私としては大歓迎!国内でやる場合であっても、下っ端に支えられたウォーター・フォールってのはやっぱり無理があると思いますもん)。しかし、アジャイルを採用したとしても、やはり高いスキルを持ったプログラマーが必要になってしまいますから、ベトナムの教育が問題になっちゃう。教育問題のソリューションにはならないわけですな……。
うぅ、どうしましょう?
幸いなことに、プログラミングの学習には、特別な設備が不要だという特徴があります。この特徴を利用しましょう。プログラミングの勉強は、コンピューターとインターネット、あとは少しの本があれば可能。だから、学校教育では不足する分を独学で補うことが可能。そしてモノ作りであるプログラミングは面白い。ということは?そう、独学で不足分を補った優秀な人が、一定の割合で存在するはずです。
ベトナムでは、その独学で不足分を補っている人を探すことにしましょう。そしてそのために、応募者の数を揃えることにしましょう。100人に1人の人材を10人集めたいのであれば、1,000人の応募者を集めればよいわけです。
そのためにはどうすればよいか?同業他社よりも高い給与です。会社を選ぶ際の第一の要因は、ここベトナムでは金なのですから。身も蓋もない話で恐縮なのですけど、「金でカタが付くのだから簡単」と前向きに考えちゃいましょう。発展途上国なので、金額もタカが知れていますしね。
プログラミングのテストをして、ダメな応募者をふるい落としましょう
大量の応募者の全員に対して、大きなコストがかかる面接を実施する必要はありません。ベトナムでは、簡単なプログラミングのテストをするだけで、ダメな応募者をふるい落とすことができます。
以下、順を追って考えます。
前節での考察で、採用のターゲットは、独学で学校教育の不足分を補った優秀なプログラマーだと結論しました*2。ただ、気をつけて欲しいんですけど、暗記中心のベトナムの教育の影響で、独学の際にも暗記中心にやってしまう場合があるんですよ。知識はあるけど理解をしていない場合は実際に手を動かしてプログラミングすることはできないわけで、それでは現場では役に立たないので困っちゃう。
というわけで、応募者が独学で勉強していて、しかも内容を暗記ではなくて理解しているかどうかを、チェックすることにしましょう。「教わっていない」ことを「実際にやらせる」わけです。
さて、ここで思い出して頂きたいのは、前節で述べたベトナムのプログラミング教育のレベルの低さです。教育レベルが高い場合には教わっていないことを探すのは大変ですけど、教育レベルが低いベトナムなら簡単です。あと、高度な内容を理解しているか確認するのは難しいですけど、レベルが低い内容を理解しているか確認するのは簡単です。というわけで、ベトナムでは簡単なプログラミングのテストで、ダメな応募者をふるい落とすことができます。
具体例をあげましょう。2012年7月現在だと、「再帰」とか「コレクション・ライブラリの適切な利用*3」とかを使えば、独学をやっていて、しかも、内容を理解しているかを判断できます。レベルが低すぎて嘘だと思うかもしれませんけど、ベトナムだと、本当にこの程度のテストでほとんどが落ちちゃうんですよ。
私がやった中で効率が良かったのは、再帰を使っていてバグがあるプログラムを修正させる方式でした。応募者に、以下のようなプログラムを見せます。
public class Factorial {
  public int calculate(int number) {  // number must be more than 0.
    if (number == 1) {
      return 1;
    }

    return calculate(--number) * number;
  }

  public static void main(String[] args) {
    System.out.println(new Factorial().calculate(5));  // It will show answer of 1 * 2 * 3 * 4 * 5.
  }
}
上のコードを見て、「return calculate(--number) * number;」の「--number」の部分がおかしい*4ことが分かれば、面接に進む。分からなければ、適当に時間を潰してお帰りいただく。レベルを少し下げてもよくて、採用にかけられるコストに余裕がある場合は、机上ではなく、コンピューターを貸して、実際にデバッグさせてもよいでしょう*5。
こんな感じのプログラミングのテストで、ダメな応募者のふるい落としができます。たぶん、応募者の数を1/10から1/100くらいに減らせるでしょう。問題の流出に対応するために、定期的に問題を変更すればパーフェクト。レベルが低い問題でよいのですから、問題の変更は容易でしょう。
面接で、何らかの技術の説明をさせましょう
ダメな応募者をふるい落とした後の面接では、自分が好きな技術の説明をさせるのがよいと考えます。うまく説明できるかどうかではなく、「その技術をよいと考えている理由」の内容で採用/不採用を決めます。
以下、その詳細です……が、まずはごめんなさい。以下は、ベトナムという特殊事情はあまり入っていません。だって、面接から先は、日本の場合とあまり変わらないですからね。あと、かなり個人的意見が入っています。こいつが一緒に仕事をしたいと思うタイプのプログラマーはこんな感じで、このように集めているんだな、とでもお考えください。
さて、マンホールの蓋が丸い理由について聞いても、バスに人が何人入れるかを聞いても、富士山を移動させる方法について聞いても構わないのですけど、私は、技術者同士なのだから、技術について語り合うのが一番良いと考えています。
その際に気を付けるべきは、知識量を争わないことです。私のようなヲタクは知識量を誇ってしまいがちで、そして知識量勝負はとても楽しいのですけれど、それだと技術を聞きかじっただけの実際には手が動かない人を採用してしまう危険性があります。だからやはり、応用が可能なレベルまで理解しているかを確認すべきだと考えます。
私は、応募者に好きな技術を選択させ、その技術が優れていると思う理由を説明させることで、技術を理解しているかどうかを判断できると考えています。昔、これは日本での話なのですけれど、Visual Basic 6.0からVisual Basic.NETに書き換えるプロジェクトで、「VB6のプログラムをVB.NETで書き換えるべき理由」を「AndAlsoとOrElseがあるため」から語り出した応募者がいました。彼は実に良かった。これらの言語要素がある場合はパフォーマンスはもちろん、コードが綺麗になるということを説明しだして、話が飛んでVB6の良いところと悪いところ、C#が人気だがVB.NETでも変わらないと思うということ、C#はたしかに文法が優れているけれどIDispatchはVBの方が楽*6なこと。これらを、コードを書きながら主張してきました。説明は下手でしたし、彼が出した結論には同意できない部分もありましたけど、もちろん、即採用です。
逆の不採用になる場合は、以下のようなケースです。「Javaが好きです」「その理由は?」「Write once, run everywhereなところが」「えっと、続きは?」「はい?Write once, run everywhereなところですけど……」「もう少し詳しく話すか、2番目に好きな他の点をあげてくれませんか?」「Write once, run everywhereというのは、一度書けばどこでも動くということです」「そうですか……」
初級の教科書に書いてあるだけの話を、繰り返して聞いている暇なんかねーんだよ!Wreite once, run everywhereな他の言語と比べて優れている点、たとえば、JVM(Java Virtual Machine)のパフォーマンスがいかに優れているか*7とかを説明して欲しい。Write once, run everywhereを安価に実現できている理由、たとえば、JVMをコンパクトに作れる理由*8等を説明して欲しい。
上であげた例は意味がない議論だと感じるかもしれませんけど、自分が好きな技術についてなのですから、意味がないような部分まで理解していて当たり前ですよね。
で?
以上でめでたく採用した後は、ひたすら仕事をさせましょう。給料の分を超えて働け!そうしてくれないと、日本人というだけで偉そうにしていて実際には働いていない駐在員の私の給料が出ないんだから……。
と、思ったのですけど、優秀な人を集めて、さて、いったいどんな仕事をさせましょうか?
ビジネス・アプリケーション開発のウォーター・フォールの下っ端……は、優秀なプログラマーにやらせるべき仕事ではないでしょう。工夫する余地が少ないので、繰り返してやっていると、せっかく選別した優秀なプログラマーがだんだん馬鹿になってしまいます。なにより、楽しくないし。
というわけで、せっかく優秀なプログラマーを集めたのですから、ビジネス・アプリケーション開発をアジャイルで……やるのは、日本でも流行っていないのにねぇいったいどうやって?この前読んだIPAの報告書では、アメリカやイギリスではすでに主流、デンマークやブラジルでは普及が進んでいると書いてあったのですけど、日本ではまだまだ(IPAの報告書では、日本と中国で普及が進んでいないと書いてあった)ですよね。プログラマーの一人としてとても悲しいけど、それが現実ならばしょうがない。
そうだ、プロダクトの開発ならば、アジャイルが適用できそう。ソーシャル・ゲームの会社がベトナムに子会社を作っていましたけれど、あれはうまく行くかもしれない(実情は全く分からないけど)。SIerではない企業が情報子会社をベトナムに作る場合も、アジャイルできそう。システム開発をSIerに発注せざるを得ないのは技術力不足という問題が理由だと思うのですけど、ベトナムに優秀なプログラマー*9を確保できるのであれば、この問題を解決できます。基幹システムは企業の競争優位性に直結しているわけで、その基幹システムを内製化できるのですから、あれ、かなり良いかもしれません(勢いで書いただけであまり考えていないので、大きな落とし穴があるかもしれないけど)。
あれ、SIerに務めている現在の自分自身を否定しちゃった……。
ともあれ、選別さえきちんとやれば、ベトナムのプログラマーは素晴らしいですよ、本当に。
*1:C言語とLispとSmalltalkを完璧にマスターした人は、他のどんな言語でもすぐに使いこなせると思う。
*2:これは、日進月歩のコンピューター業界での必須能力でもあるでしょう。
*3:.NET FrameworkのLINQの、クエリ式ではない方の活用とか。
*4:これだと、先に--されるので「1 * 2 * 3 * 4」になっちゃう。だからreturn calculate(number - 1) * number;が正解。return number * calculate(--number)でも動作はするけど、再帰の際に呼び出し側の状態が変わるというのは危険なので避けるべき。
*5:模範解答を暗記しただけの場合があるので、実際にデバッグできるかどうかを確認するのはとても有効です。
*6:当時の話。今はC#でも楽。
*7:「仮想マシンを使えばどこでも動くのは当たり前で、SmalltalkなんかOS全体と呼べるようなレベルまで仮想マシンが対応している。JVMの特筆すべきは、そのパフォーマンスである。JITコンパイラは……」とか話して欲しい。
*8:「JVMはレジスタ型ではなくて、スタック型だ。その結果として、コマンドが少なくて済んでいて……」とか話して欲しい。
*9:私は、開発作業の全てに対応できる人という意味で、プログラマーという言葉を使用しています。SEという、日本にしか存在しない職種は絶対に認めません。
もう悪質なコード・ジェネレーターには騙されない!
突然ですけど、皆様は「コード・ジェネレーターで生産性向上」って宣伝文句を聞いたことありませんか?私はこの業界が長いので何回も聞いたことがあって、しかも多くの場合に生産性の向上はありません(むしろ悪化)でした……。
騙されたー!あー悔しい!今ここで具体的なプロダクト名を挙げて攻撃してやる……なんてのは時間のムダです。だって、そんな実利がないプロダクトはとっくの昔に消滅していますから。
嘘だらけの宣伝文句に騙されて私に調査するよう命令した技術を知らない会社の上層部を実名をあげて攻撃……するのは私の保身のために勘弁してください。目を付けられまくっていて、会社での立場が既に無いんですから。
というわけで、今回は、悪質なコード・ジェネレーターから身を守る方法についてやりましょう。
コード・ジェネレーターは特別な存在ではありません
そもそも、コード・ジェネレーターなんて、別に特別なモノではありません。だって、我々プログラマーにはお馴染みの道具であるメタプログラミングとそれほど違わないのですから。実行前にソース・コードを生成する(コード・ジェネレーター)か、実行時にプログラムそのものを生成する(メタプログラミング)かの違いでしかないわけです。
さらに言ってしまえば、メタプログラミングのテクニックを使っていない普通のプログラムとも、実はあまり違いません。
例をあげましょう。以下のXMLを入力にする、SQLのDDL(Data Definition Language)のジェネレーターを作る場合で考えてみます。
<? xml version="1.0" ?>
<ddl>
  <table name "employees">
    <column name="id" type="int" primary_key="true" />
    <column name="name" type="text" />
  </table>
</ddl>
たぶん、「columnタグのname属性を取得して、create tableの後ろに繋げて……」というような処理を書くでしょう。そして、その結果として出来上がったDDL文をファイルに出力する処理を追加すれば、はい、新たなコード・ジェネレーターの完成です。
でも、もし、処理結果をファイルとして出力しないで、データベースに直接渡してしまうことにしたら?それは、コード・ジェネレーターではなく、ごく普通のプログラムになります。でも、やっていることもできることも、さっき述べたコード・ジェネレーターとほとんど同じ……。
そう、コード・ジェネレーターなんて、メタプログラミングすら使っていない普通のプログラムと比較しても、大きな違いは無いんですよ。
コード・ジェネレーターならではの優位性なんてありません
コード・ジェネレーターには「生成したコードを活用(具体的には修正)することができる」という優位点があるように思えるかもしれません。
でも、この意見はおかしいです。だって、日夜プログラムを書いている我々ならばよく知っているように、プログラムは何度も何度も修正されるものなのですから。ジェネレート結果を修正して、で、再ジェネレートのたびに同じ修正をやり直すなんてのは、世界で3番目くらいの愚行でしょう。
ジェネレート結果の修正結果を取り込めるならば、この問題は解消できるように思うかもしれませんが、これもおかしいです。
考えてみましょう。ジェネレート元とジェネレート結果を比較した場合、ジェネレート結果の意味的な大きさは、「小さい」か「等しい」か「大きい」かのどれかになります。
ジェネレート結果が「小さい」場合と「等しい」場合は、完璧な取り込みを実施できます。ジェネレート結果の修正箇所に対応する箇所が必ずジェネレート元に存在するわけで、そこを修正すれば取り込みは完了するのですから。
でも、この場合の取り込みは「無意味」な場合が多いと考えます。日本語の論文を英語に翻訳する場合で、翻訳コストはゼロの場合で考えてみてください。翻訳結果である英語の方を修正して、日本語に再翻訳するなんてのは、とっても無意味でしょ?この場合の取り込みは「無意味」なわけです。
残る「大きい」場合について考えてみましょう。この場合は、取り込みは限定的になってしまい、プログラミングに制約が出て、プログラミングの生産性を落としてしまう結果になると考えます。
例をあげます。「required」の1語を書くだけで、JavaScriptでの必須チェックとサーバー・サイトでの必須チェックがジェネレートされると仮定します。この場合は、JavaScriptの必須チェックだけを削除すると、再取り込みはできなくなってしまいます。だって、「required」の1語に対してどのように反映していよいか分からなくなっちゃうのですから。
つまり、プログラミングの際に修正してもよい内容はこれこれのみという制約が発生しちゃうわけです。ただでさえ難しい(だから皆様のようなスペシャリストが存在している)プログラミングに更なる制約を追加するなんて、これはもう最悪の話です。それくらいなら、取り込みなんかやらない方がよいでしょう。
というわけで、取り込みを加味した場合の結論*1は以下の通り。ジェネレート結果の取り込みは実施しない、よって、ジェネレート結果は修正しない、だから、「ジェネート結果が見えないメタプログラミングや普通のプログラミングとコード・ジェネレーターには違いがない」のです。
にもかかわらずコード・ジェネレーターという言葉に騙される人が多いのは何故なのか?私は、人間は目に見えないことはなかなか実感できない生き物だからなのだと思います。ClojureやRubyの短いコードで目に見えない複雑な処理が実行される場合より、目に見えるJavaの長いコードが生成されることの方が凄いと感じてしまうんです。
コード・ジェネレーターであることを喧伝しているということは、その効果を過大評価させようとしていることなんです。騙されちゃ、ダメ、絶対!
入力に着目しましょう
勘違いしないでください。私はコード・ジェネレーターそのものを否定しているわけではありません(たとえば、Visual StudioのCode Snippetsは大好き)。メタプログラミングでも入力に基づいて処理する普通のプログラムでも同じ効果を得られるのだから、コード・ジェネレーターという実装手法そのものを評価すべきではないと主張しているだけなんです。
だからそう、そのコード・ジェネレーター(やメタプログラミングを活用したライブラリや普通のプログラムやライブラリ)が実際に何をしてくれるのかに着目することにしましょう。
出力が大きいから凄いとは限りません
何をしてくれるかに着目する際に、ジェネレート結果のみに着目してはダメです。凄い成果物をジェネレートしてくれるからといって、そのコード・ジェネレーターが優れているとは限りません。
考えてみましょう。一般に、大きな成果物を手にいれるには、大きな入力を用意してあげればよい。その証拠に、裸のJavaだって、大量のコードを書けば大きなビジネス・アプリケーションを作れます。でもそれでは大変でコストがかかり過ぎちゃうから、コード・ジェネレーターを使うんですよね?で、もし、出力と同じだけの入力を必要とするコード・ジェネレーターがあったとしたら、貴方どう思いますか?
そんな馬鹿らしいプロダクトはないだろうとお考えかもしれませんが、実はこれがあるんですよ。
たとえば、出来が悪いJavaのフレームワークでのXMLによる設定部分とか(コード・ジェネレーターではないですけれど)。コードに書くのと同じ内容をXML形式で書いて、で、記述量が増えた上にコンパイラによるチェックもデバッガを用いたデバッグもできなくなって、ほら、何もいいことがない……。
あと、Excelの詳細設計書からコードを生成するようなプロダクトにもダサい場合があります。画面定義のコードと同じ内容をExcelに書かせて、やっぱりコンパイラによるチェックもデバッガを使用したデバッグもできなくなって、さらに設計者と呼ばれる(理由は不明だけど)単価が高い人間の作業を増やしてトータルのコストを大きくしちゃってもう大変……。
他には?あれだ、create table文と同じ内容の入力を強要されるER図……は良いですね。あれ、どうしてなんだろ?
入力こそが重要です
ER図は、エンテティ(テーブル)間の関係を図として示してくれます。で、図になると理解しやすくなる事柄って多いんですよ。ER図という記法はデータ構造という複雑なものを人間が理解する手助けをしてくれるわけで、だから入力と出力の量が同じであっても良いのだと考えます。
Ruby on Railsも良いですね(コード・ジェネレーターではないけど)。私が先に述べた出来が悪いJavaのフレームワークのXML問題を「設定より規約」で解消しています。「同じことを繰り返さない」を徹底しているのも素晴らしい。データベースを見ればどのようなカラムがあるのかは分かる。だから、カラムに相当するデータ入出力のためのメソッドを書く必要なんかないと主張して、その通りになっています。
逆に、この前見た、ビジネス・アプリケーションを丸ごとジェネレートするプロダクトはダメでした……。このプロダクトはモデルとして定義した情報を活用するのですけれど、モデルの記述も活用も中途半端。あと、ロジックは独自言語で書くのですけど、これがもうダメダメ言語でした。
いったい何が違うのでしょうか?私は、理論の有無が相違点なのだと考えます。モデルとして定義する内容はこれで十分なのだという理論、ロジック記述用の独自言語が他の言語よりも優れているという理論、これらがありませんでした。結果を作成するために必要になるものを機械的に並べただけの入力でしかなくて、理論も何もありません。そんな状態ではRuby on Railsのような高い生産性が出るはずありませんな。
結論。そのプロダクトが採用した入力が他のプロダクトが採用している入力よりも優れていることを説明できないプロダクトは、評価*2に値しません。近寄ってはダメです。必ず騙されてひどい目にあっちゃいます。
……えっと、当たり前すぎる結論でごめんなさい。
まとめ。悪質なコード・ジェネレーターに騙されないために
強引だけど、まとめます。
1. コード・ジェネレーションの利点を述べている部分は見るな。その部分は、効果を誇大広告しているだけだ。
2. ジェネレート結果が大きくても感心はするな。ジェネレート結果と同じ大きさの入力を要求される場合、結果の大きさは無意味である。
3. 入力がいかに優れているかを述べている部分に着目せよ。入力の理論こそがコード・ジェネレーターの肝である。
最後に、ダメな場合の宣伝文句の具体例をあげておきましょう。最初の方で述べたSQLのDDLジェネレーターでやってみます。
設計書に書く頻度が高いselectやupdateやdeleteの文法は覚えているだろう。でも、create table文はどうか?テーブル登録という稀にしか実施しない処理のための構文を覚えておけというのは、あまりにも過酷な要求ではないだろうか?
この構文を入力するためにデータベース・エンジニアを雇う?異論を挟んで申し訳ないが、その選択には賛同できない。そのコストは、コード・ジェネレーションでcreate table文を生成すれば、未来永劫ゼロにできるからだ。
機能が不安?その不安はもっともだが、我社のスーパーDDLジェネレーターには当てはまらないので安心して欲しい。SDG(スーパーDDLジェネレーターの略称)は、たとえば一時表を作るためのcreate table asまでサポートしている。create tableのマイナーなオプションであるinitially immediateやinitially deferredにも対応している。SDGは、Oracle、SQL Server、DB2、MySQLとPostgreSQLが持つすべてのテーブル作成の構文に対応している(詳細は、機能一覧を参照して欲しい)。SDGがあれば、すべてのテーブル作成の作業を実施することが可能なのだ!
SDGの入力は、業界標準であるXML形式を使用している。さらに、最新バージョンではExcelでの入力にも対応した。そう、使い慣れたExcelからSQLのコードをジェネレートできるのだ!(終わり)
まぁ、ここまであからさまではないでしょうけど、似た宣伝文句は多いと思いますよ。こんなプロダクトには絶対に近寄ってはダメ、絶対!
Clojureでアスペクト指向プログラミング(その2)
前回の続きです。
とはいっても、実は私、Clojureについては「プログラミングClojure」で学んだだけ(しかも、Common LispもSchemeも経験がない)という、とても弱っちい状態なんですよ。
ですから、Clojureでアスペクト指向する際には、それはもーいろいろと試行錯誤しました。で、今回の投稿では、私がClojureでアスペクト指向をするために辿った経緯をそのまま書いてみます。
読むのに時間がかかる上に、分かっている人には当たり前の話が多いとは思いますけど、Clojureの学習のやり方として参考になるかもしれませんから、どうかご容赦の程をお願いいたします。
基本方針
アスペクト指向プログラミングを実現するには、関数の実体を取得して、その実体の始めか終わりにアスペクトとして実行したい処理を追加するだけでよいはず。
ただ、残念なことにそのやり方が皆目検討つきません……。そこで、Webブラウザを起動してhttp://www.clojure.org/を開いて、[Reference]リンクをクリックしました。原典をあたるのは基本ですもんね。
英語に四苦八苦しながら上から読んでいくと「Vars and the Global Environment」に書いてある内容が、アスペクト指向プログラミングに役立ちそうです。書いてある内容は以下の通り。
Functions defined with defn are stored in Vars, allowing for the re-definition of functions in a running program. This also enables many of the possibilities of aspect- or context-oriented programming. For instance, you could wrap a function with logging behavior only in certain call contexts or threads.
defnで定義された関数はVarに格納され、プログラム実行中に再定義することが可能である。このことは、アスペクト指向プログラミングやコンテキスト指向プログラミングを可能にする。たとえば、ある呼び出しコンテキストやスレッドの中でのみ、ログ出力でその関数を囲むことを可能にできるのだ。
翻訳には自信がないけれど、aspectという言葉が入っているから、多分そのものズバリのはず。というわけで、Varについて調べれば「関数の実体を取得する」のは実現できそうです。
さらにその文書の少し前の部分には、with-redefsやwith-redefs-fnは静的なVarsを再定義する目的で提供されていると書いてあります。with-redefsやwith-redefs-fnがどうやって再定義しているかを調べれば、「関数の前後に処理を追加する」のも出来そうです。
はい、これで基本方針が決まりました。
関数の実体を取得する
でも、実はVarが何なのか分かりません……。たぶん、VARiableのvarなんだろうなぁ、という程度の知識しかないんですよ、私ってば。
でも平気。分からないことは調べればよいんですから。私はプログラマなので、プログラム・コードのレベルで調べた方が効率がよい。ただし、何も指針が無い状態で調査するのはあまりにも大変ですから、まずはCheat Sheetを開きました。Clojureの場合はhttp://clojure.org/cheatsheetですな。
そのCheat Sheetの中の「Vars and global environment」を見ると、var?関数を使えばVarなのかそうでないのかを判断できそうです。REPLを開いて、さっそく実験してみます。
user> (def x 1)
#'user/x
user> (var? x)
false
ええっ?xはVarじゃないの?と、混乱しないで、慌てず騒がずClojureDocsのサイトでvar?について調べます(Cheat Sheetのvar?をクリックすると、ClojureDocsのvar?について述べているページに遷移します)。
ClojureDocsに挙がっている例(例を書いてくださった方、ありがとうございます)を見ると、(var 名前)とやらないとVarとして扱われないことが分かりました。で、このvarスペシャル・フォームのリーダー・マクロが「#'」。というわけで、再実験します。
user> (var? (var x))
true
user> (var? #'x)
true
はい。trueが返って来ました。ついでなので、このxってのは何なのかも調べてみましょう。ClojureはJavaの上に作られていますから、classを問い合わせればわかるはず。
user> (class (var x))
clojure.lang.Var
user> (class x)
java.lang.Long
はい、xに束縛された値である1のclassはLongなのですね。……私はこんなことが知りたかったわけじゃないやい!というわけで、少しふてくされて、clojure.orgのReferenceに戻ります。
そうしたら、「Vars and the Global Environment」の中に面白い記述を見つけました。
The Namespace system maintains global maps of symbols to Var objects (see Namespaces).
名前空間システムは、シンボルからVarへのグローバルなマップを管理する(名前空間を参照)。
ということは、xをシンボルに変換して、それをキーにすれば名前空間が管理するマップからVarを取得できるってことになります。xがいったい何なのかは気にしないことにして、この有望な情報をREPLで試してみましょう。
Cheat Sheetによれば、ns-interns関数で名前空間にインターン(名前空間が管理するマップにシンボルとVarを対応付けて登録する指す言葉らしい)されたシンボルとVarを取得できるみたい。REPLを再立ち上げして、さっそく試してみます。
user> (def foo "f")
#'user/foo
user> (defn bar [] "b")
#'user/bar
user> (ns-interns 'user)
{bar #'user/bar, foo #'user/foo}
おお、シンボルとVarのマップを取得できました。更に試してみます。
user> (def b (get (ns-interns 'user) 'bar))
#'user/b
user> (b)
"b"
素晴らしい。取得したVarを関数として呼び出せました。そうそう、アスペクト指向プログラミングは変数の場合は何もする必要がないわけですから、関数かどうかの判定が必要ですよね。試してみます。
user> (fn? b)
false
……あれ、関数として呼び出せたのに、関数ではないの?混乱してきました。可能性は2つ。1.fn?は関数かどうかを返す関数ではない、2.実はbは関数ではない。馬鹿らしいとは思いつつも、1を試してみます。
user> (fn? bar)
true
関数を引数に指定したら、fn?はtrueを返してきました。ということは「実はbは関数ではない」のでしょう。別の角度からもう一度確認してみます。
user> bar
#<user$bar user$bar@7e896e10>
user> b
#'user/bar
あらら、確かに違いそうですね。よく考えてみたら、(var bar)した結果がVarなわけで、bはVarなのですから、varの反対向きの操作が必要なはずです。でもその方法が分かりません……。JavaとかC#なら、メソッド一覧をIDEが出力してくれるのでしょうけど、Clojureではそんなのは無理ですし……。
というわけで、我々が大好きなソース・コードを見てみます。Clojureのすべてのコードは、https://github.com/clojure/clojure.gitからダウンロードできます。ダウンロードして、clojure/src/jvm/clojure/lang/Var.javaを開いてみました。
すると、ありました。「final public Object deref()」というメソッドが定義されています。derefってのはRefやAgent、Atomから値を取り出すときに使う関数ですから、目的に合致しそう。しかも、さっき読んだ「Vars and the Global Environment」の一行目に、VarはRefやAgent、Atomの仲間だとも書いてありました。
ただ、念の為に、clojure/src/clj/clojure/core.cljを開いて、deref関数の定義部分を見ておきましょう。
(defn deref
  ([^clojure.lang.IDeref ref] (.deref ref))
  ([^clojure.lang.IBlockingDeref ref timeout-ms timeout-val] (.deref ref timeout-ms timeout-val)))
おお、Javaで定義されたderefメソッドを読んでいるだけだ。derefで正しいという根拠が増えたことになるので、もう我慢できずに試してみます。
user> (fn? (deref b))
true
やったよママン!fn?でtrueが返ってきました。これで関数の実体を手に入れたことになります。
関数の前後に処理を入れる
関数の実体は手に入ったけれど、でも、どうやって関数の前後に処理を入れればいいのでしょうか?いったい関数の中身はどういう形になっているのかなぁ。空の向こうには何があるのかなぁ。clojure.orgのReferenceを見ても、関数の中身がどうなっているのかは書いていないなぁ……。
と、どうにもならなくなってしまった場合は、基本の基本に立ち返りましょう。Google先生です。ここまでGoogle先生に頼らないようにしていたのは、Google先生は優秀すぎるので、Clojureでのアスペクト指向プログラミングの実現方法のすべてを教えてくれちゃう危険性があったから。いろいろ考えるのが楽しいんですから、答えを見つけちゃう可能性がある行動は避けなければなりません。
でも、背に腹は変えられないですので、Google先生で検索してみます。「clojure aspect oriented programming」で検索します。
はい、一番上のhttp://stackoverflow.com/questions/5573418/aspect-oriented-programming-in-clojureに、関数に処理を追加する方法が載っていました。ラムダ関数を作ってしまえば良いんですね。さっそく試してみます。
user> (def b' (fn [& args] (do (println "BEFORE") (apply b args))))
#'user/b'
user> (b')
BEFORE
"b"
BEFOREと出力されています。やりました!関数の前に処理を入れ込むことができました。あとは、作成したラムダ関数で最束縛する方法を調べるだけです。
で、最初の方で述べたように、関数を再束縛する方法はwith-redefsやwith-redefs-fnを調べれば分かりそうです。ですから、ソース・コードを見てみることにしましょう。clojure/src/clj/clojure/core.cljを開きます。
with-redefsマクロはその中でwith-redefs-fn関数を呼び出しているだけなので、with-refefs-fnの方をじっくりと調べます。with-redefs-fnの中身は、以下の通り。
(defn with-redefs-fn
  [binding-map func]
  (let [root-bind (fn [m]
                    (doseq [[a-var a-val] m]
                      (.bindRoot ^clojure.lang.Var a-var a-val)))
        old-vals (zipmap (keys binding-map)
                         (map deref (keys binding-map)))]
    (try
      (root-bind binding-map)
      (func)
      (finally
        (root-bind old-vals)))))
このコードから、以下の2つのことが分かりました。
1.derefで関数を取り出すという、先ほど推測した方式は正しかった(old-valsのコードでderefを使用しているため)。
2.再束縛は、VarクラスのbindRootメソッドを呼べば出来そう(だって、それ以外の処理はしていないですもん)。
念の為、Java側のbindRootメソッドの中身も読んでみます。
synchronized public void bindRoot(Object root){
	validate(getValidator(), root);
	Object oldroot = this.root;
	this.root = root;
	++rev;
    try
        {
        alterMeta(dissoc, RT.list(macroKey));
        }
    catch (Exception e)
        {
        throw Util.sneakyThrow(e);
        }
    notifyWatches(oldroot,this.root);
}
うぅ、Javaのコードは分かりづらい……。正直、全く分かりません。Javaで検証するのはきっぱり諦めて、Clojureのコードを書いて検証することにしました。
ま、多分平気でしょ。関数の前後に処理を入れる方法は分かったことにしてしまいます。間違えていたらやり直せばいいんですしね。
Clojureでアスペクト指向プログラミング
以上、必要な調査が終わりましたので、コードを書いてみます。今回は遊びなので、機能は簡単にしました。名前空間と関数を指定したら、その名前空間の中にある関数を実行する前に、指定した関数が実行されることにします。
というわけで、作成したコードはこんな感じ。
(ns clj-aspect.core)

(defn weave-aspect
  [namespace aspect-fn]
  (doseq [v (->> (ns-interns namespace)
                 (vals)
                 (filter #(fn? @%)))]
    (let [f (deref v)]
      (.bindRoot v
                 (fn [& args] (do (aspect-fn)
                                  (apply f args)))))))
今回は、with-redefsにあった元に戻す処理は省略しました。元に戻す処理を書いちゃうとwith-redefsとほとんど同じになっちゃって、もしほとんど同じならばwith-redefsを呼び出す形で実装すればよいことになっちゃって、その場合は一番面白い部分のコードを書けなくなっちゃいますからね。
コードが書けたので、REPLで動かして試してみます。
user> (use 'clj-aspect.core)
nil
user> (defn foo [] (println "FOO"))
#'user/foo
user> (def bar "BAR")
#'user/bar
user> (weave-aspect 'user #(println "ASPECT"))
nil
user> (foo)
ASPECT
FOO
nil
user> bar  # 変数は影響を受けていないことを確認します。
"BAR"
やったぁ!動きました。FOOの前にASPECTが出力されています!プログラムとしてテストを書いてきちんとテストして、injectする関数を正規表現で指定できるようにして、前だけじゃなくて後にも差し込みできるようにして、引数をアスペクトにも渡すようにして、で、状態を元に戻す処理を追加してあげれば、それなりに使えるライブラリになるかもしれません。そのうち、暇ができたらやってみることにしましょう。
ともあれ、本を一冊読んだだけの頭が硬くなっているおっさんの私でもアスペクト指向プログラミングのライブラリ(の雛形ですが)を作れちゃうんですから、Clojure関連の文書と、オープン・ソースなのでソース・コード見放題ってことと、あともちろんREPLは素晴らしいですな!
